
Claude Opus 5.5 chegou. O que muda para quem usa IA no trabalho
O novo modelo da Anthropic entrega o resultado do topo de linha por cerca de 40% menos e escreve mais claro. Comparação, custo sem jargão e quando usar.
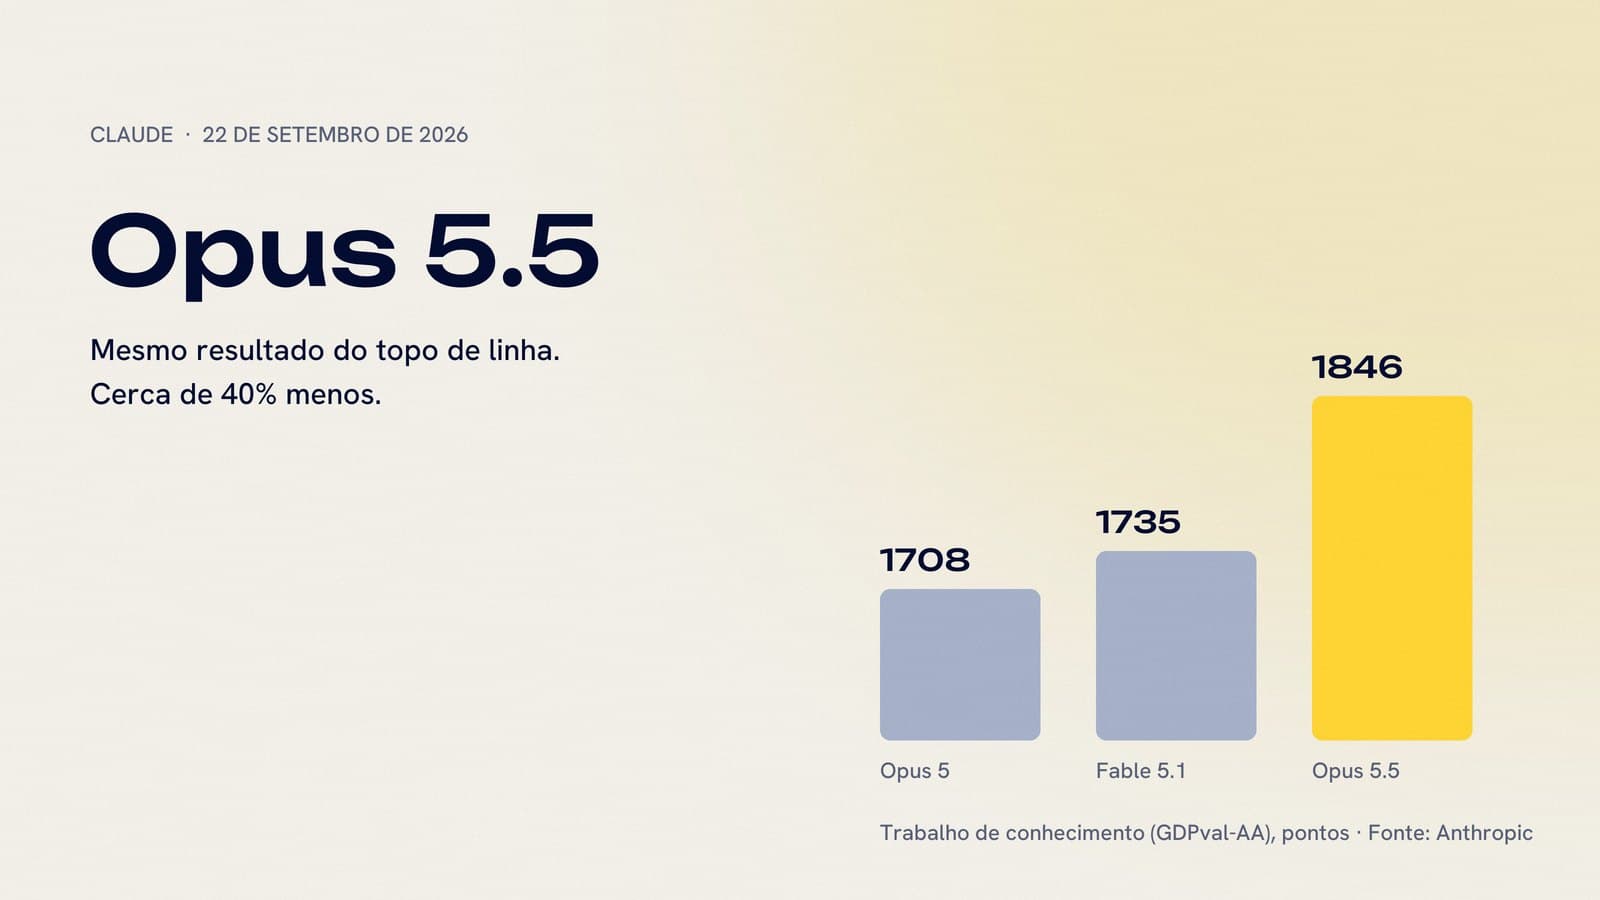
- O Claude Opus 5.5, lançado em 22 de setembro de 2026, entrega o resultado do modelo topo de linha da Anthropic por cerca de 40% menos.
- Para quem usa o Claude no aplicativo, a mudança mais sentida é a escrita: respostas mais claras, mais curtas e com o importante primeiro.
- Para empresas que rodam agentes, ele faz a mesma tarefa em menos passos, o que reduz custo e tempo de espera.
- Não é para tudo: tarefas simples e de alto volume continuam mais baratas no Haiku e no Sonnet.
A Anthropic lançou hoje o Claude Opus 5.5, o primeiro modelo da família Claude 5.5. Não é uma versão "um pouco melhor". É um modelo que entrega o que só o topo de linha entregava, por menos dinheiro, e que escreve de um jeito mais fácil de ler.
Este texto é para quem usa IA no trabalho sem programar: quem conversa com o Claude, quem tem um agente atendendo clientes, quem paga a conta no fim do mês. Deixamos o jargão de lado e ficamos com o que muda na prática.
O que mudou, em linguagem de gente
Três coisas importam para quem não é desenvolvedor.
Escreve melhor. A Anthropic diz que o Opus 5.5 apresenta a informação mais importante primeiro, usa menos jargão e responde de forma mais curta e organizada. A Box, empresa de gestão de documentos, mediu respostas 40% mais enxutas sem perder precisão. Para quem lê dezenas de respostas por dia, isso é tempo.
Faz a mesma tarefa em menos passos. Quando um agente de IA executa um trabalho, ele dá vários passos: lê, decide, usa uma ferramenta, confere, repete. O Opus 5.5 chega ao mesmo resultado com menos passos. A Optiver, empresa do mercado financeiro, relatou a mesma qualidade do Opus 5 em cerca de metade do tempo, com a conta entre 40% e 50% menor.
Erra menos e desobedece menos. Nos testes da Anthropic, o modelo tenta contornar limites 85% menos vezes que o Opus 5, resiste melhor a instruções maliciosas escondidas em documentos e evita ações difíceis de desfazer. Para quem tem um agente com acesso ao CRM ou ao e-mail da empresa, isso é o que importa.
O ganho não está em fazer coisas novas. Está em fazer as mesmas coisas com menos passos e menos erros.
Como ele se compara
A Anthropic publicou a comparação abaixo. As colunas são o Opus 5.5, o Fable 5.1 (o modelo mais caro da Anthropic), o Opus 5 (o anterior) e dois modelos da OpenAI.
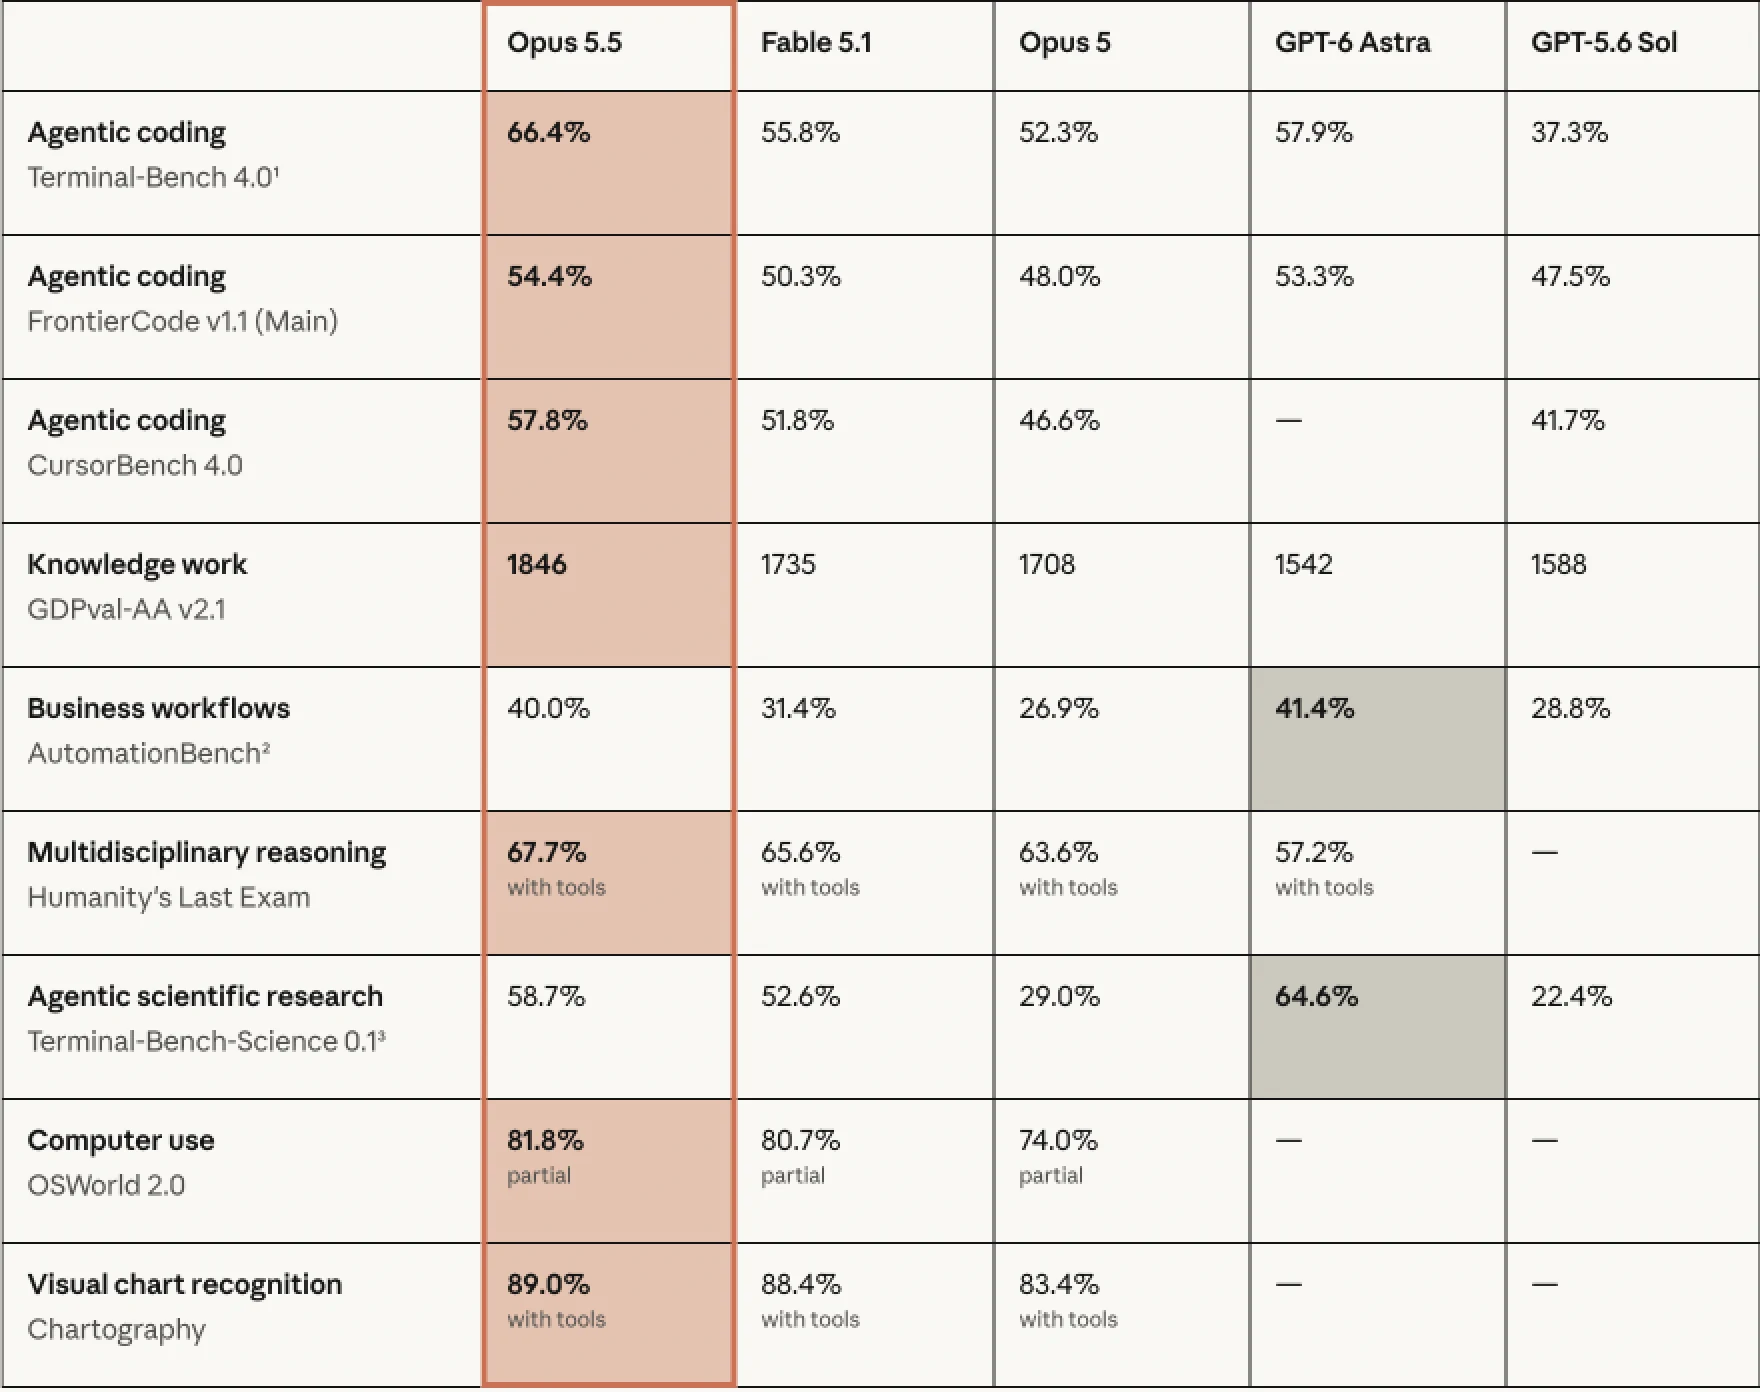
Os nomes dos testes são técnicos. O que cada linha mede, em português:
| Linha da tabela | O que mede na prática |
|---|---|
| Agentic coding (três linhas) | Programar sozinho, do começo ao fim de uma tarefa |
| Knowledge work | Trabalho de escritório: relatórios, análises, documentos. Quanto maior o número, melhor |
| Business workflows | Executar um processo de negócio de ponta a ponta, com várias etapas |
| Multidisciplinary reasoning | Raciocinar sobre perguntas difíceis de várias áreas |
| Agentic scientific research | Conduzir uma pesquisa científica com autonomia |
| Computer use | Usar um computador como uma pessoa: abrir sistemas, clicar, preencher |
| Visual chart recognition | Ler gráficos e imagens |
O ponto a notar: em sete das nove linhas, o Opus 5.5 passa o Fable 5.1, que custa mais que o dobro. É por isso que a Anthropic o coloca como o modelo padrão para trabalho longo. Nas duas em que perde, para o modelo da OpenAI, a diferença é em processos de negócio e pesquisa científica.
Quanto custa
Aqui vale separar dois mundos.
Quem usa o Claude pelo aplicativo não vê preço de modelo. Paga a assinatura e escolhe o Opus 5.5 no seletor. No lançamento, os planos Pro, Max e Team ganharam limites de uso maiores.
Quem tem agentes rodando na empresa paga pelo volume de texto que o modelo lê e escreve. Uma conversa comum custa centavos; o que pesa é a escala, um agente que atende mil pessoas por dia. Nesse mundo, o que importa é quanto cada modelo custa em relação aos outros para o mesmo trabalho:
| Modelo | Para quê | Custo para o mesmo trabalho | Velocidade |
|---|---|---|---|
| Claude Fable 5.1 | O máximo de capacidade | 2,5 vezes o Opus 5.5 | Mais lento |
| Claude Opus 5.5 | Tarefas longas e difíceis, agentes | referência | Moderado |
| Claude Sonnet 5 | O dia a dia da maioria das empresas | metade | Rápido |
| Claude Haiku 4.5 | Volume: triagem, classificação, resumos | um quarto | O mais rápido |
Em relação ao Opus 5, que ele substitui, a tabela de preços caiu 20%. Na conta real, a Anthropic fala em cerca de 40% menos, porque o modelo também faz a mesma tarefa em menos passos. Os dois efeitos se somam.
Há ainda um modo rápido, até 2,5 vezes mais veloz, que custa o dobro. Serve para quando a resposta precisa sair na hora, como um atendimento ao vivo.
Quando usar cada um
A pergunta que mais ouvimos não é "qual é o melhor", é "qual eu uso para isso". A resposta muda por tarefa.
| Tarefa | Modelo indicado | Por quê |
|---|---|---|
| Responder mensagens de clientes no WhatsApp | Haiku 4.5 ou Sonnet 5 | Volume alto, tarefa curta, precisa ser rápido e barato |
| Classificar e-mails, triar pedidos, extrair dados de formulários | Haiku 4.5 | Milhares por dia; o custo é o que decide |
| Redigir propostas, contratos e documentos internos | Sonnet 5 | Qualidade boa, preço médio, rápido |
| Analisar um contrato de 80 páginas e apontar riscos | Opus 5.5 | Precisa ler tudo, raciocinar e não inventar |
| Agente que faz um processo inteiro sozinho (pedido, ERP, cobrança, confirmação) | Opus 5.5 | Muitos passos; cada erro no meio custa caro |
| Revisar uma base de conhecimento ou um sistema inteiro | Opus 5.5 | Trabalho longo, que precisa manter tudo na cabeça de uma vez |
| Pesquisa aberta onde o máximo de capacidade justifica o preço | Fable 5.1 | Quando errar custa mais que a diferença de preço |
A regra prática: quanto mais passos e mais consequência tem a tarefa, mais o Opus 5.5 compensa. Quanto mais curta e repetitiva, mais o Haiku compensa. Sonnet fica no meio, e é onde a maior parte do trabalho de escritório acontece.
O que isso muda para uma empresa
Se você usa o Claude pelo aplicativo, a mudança é escolher o Opus 5.5 no seletor de modelo.
Se você tem agentes rodando, o ganho é de conta e de qualidade, mas não vem sozinho. O Opus 5.5 muda algumas regras de funcionamento: o raciocínio interno passa a estar sempre ligado, e há detalhes técnicos que quebram integrações feitas para o Opus 5. Trocar o modelo sem testar é o jeito mais rápido de descobrir isso pelo cliente.
Na Elev, essa troca entra no acompanhamento mensal: testamos o modelo novo com os casos reais da sua operação, comparamos com o que está no ar e só viramos a chave quando o resultado é melhor e o custo confere. Se você quer entender o que dá para assumir com IA hoje na sua operação, é por aqui.
Fontes
- Anúncio do Claude Opus 5.5, Anthropic, 22 de setembro de 2026.
- Visão geral do modelo, documentação da plataforma Claude.
- Tabela de preços, documentação da plataforma Claude.
Perguntas frequentes
Preciso fazer alguma coisa para usar o Opus 5.5?
No aplicativo do Claude, basta escolher o modelo no seletor. Quem tem agentes ou automações rodando precisa trocar o modelo na configuração e testar antes, porque o novo modelo tem algumas diferenças de comportamento. É o tipo de troca que a Elev faz dentro do acompanhamento mensal.
O Opus 5.5 substitui o Sonnet e o Haiku?
Não. Ele é o modelo para tarefas longas e difíceis. Para triagem de mensagens, classificação, resumos curtos e tudo que roda em volume, o Haiku 4.5 e o Sonnet 5 continuam fazendo o serviço por uma fração do preço.
Vale trocar o Opus 5 pelo Opus 5.5 nos agentes que já tenho?
Quase sempre. Ele custa menos, faz a mesma tarefa em menos passos e erra menos. A ressalva é testar com casos reais antes de virar padrão, porque o modo de raciocínio agora vem sempre ligado e isso muda o tempo de resposta em algumas tarefas.
Como uma empresa paga pela IA quando ela roda em agentes?
Pelo volume de texto que o modelo lê e escreve, não por usuário nem por mês. Uma conversa comum custa centavos. O que pesa é a escala: um agente que atende mil pessoas por dia. Por isso a escolha do modelo certo para cada tarefa faz diferença na conta.
E o Claude Fable 5.1, é melhor?
É o modelo mais capaz da Anthropic e continua disponível. A Anthropic diz que o Opus 5.5 entrega resultado comparável ao Fable 5.1 na maioria das tarefas, custando menos da metade. Para o dia a dia de uma empresa, o Opus 5.5 é a escolha padrão; o Fable fica para o que exige o máximo.
Receba os próximos textos.
Um e-mail quando sair texto novo. Sem sequência de vendas, sem frequência inventada.
Publicado em 22 de setembro de 2026